Conseils Oryon
Pipeline léger (test → préprod → prod) : promotion d’artefact et conditions de rollback
Pour une petite équipe, les points à considérer dans un pipeline de livraison léger : promotion du même artefact, environnements de test et de production, conditions de rollback et vérifications post-déploiement.
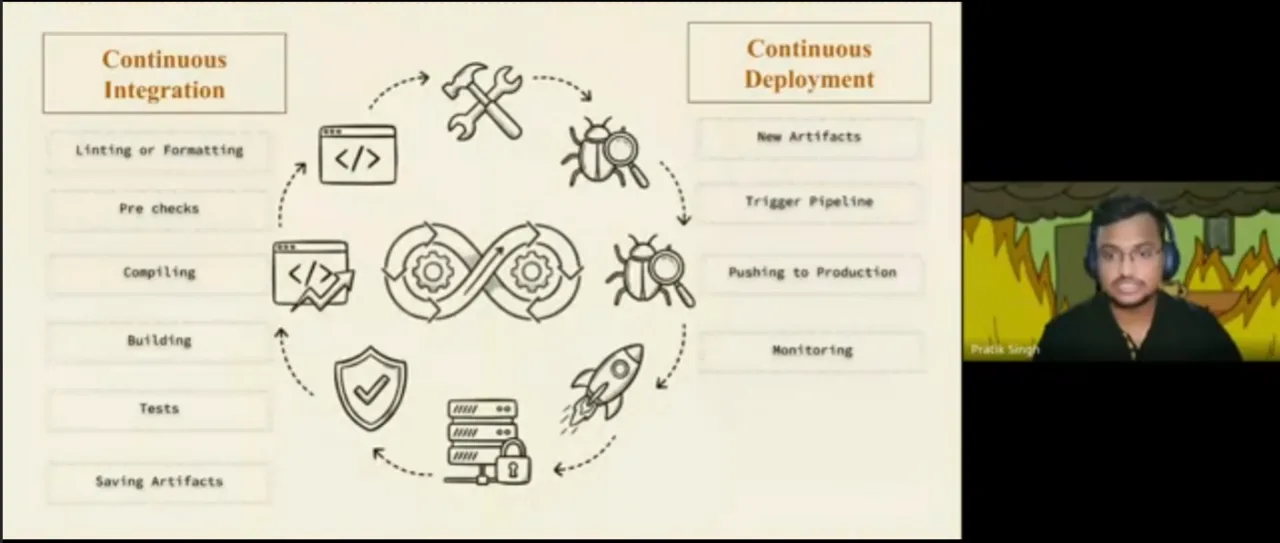

Comment organiser un flux de livraison test → préproduction → production pour une petite équipe ? Ce guide aborde la promotion d’un même artefact, la coordination des déploiements, les vérifications post-déploiement et les conditions à examiner avant un rollback, sans proposer de runbook de retour arrière.
Promouvoir le même artefact testé (build‑once) et conserver sa provenance
Construisez l'artefact déployable une seule fois à partir de la révision acceptée, publiez‑le puis promouvez exactement ce même artefact à travers les environnements ; éviter de reconstruire pour chaque étape, car un rebuild du même commit peut produire des octets différents et invalider la qualification effectuée en staging. [1]
Pour les images conteneurisées, sélectionnez l'image par son digest, par exemple une référence de forme nom-registre/nom-image@sha256:digestsuite ; un tag lisible reste pratique pour les humains, mais le digest identifie de façon sûre le contenu ; conservez la liaison entre ce digest, le commit applicatif, le pipeline de build et les tests qui l'ont qualifié, et pour un paquet versionné vérifiez son checksum et empêchez le remplacement silencieux d'une release. [1]
Conservez les artefacts nécessaires pendant la fenêtre de récupération du service, notamment les paquets de déploiement et la configuration. Dans GitLab, la rétention « latest-successful-pipeline » ne préserve pas toutes les releases antérieures : des artefacts de jobs plus anciens peuvent expirer lorsque de nouveaux pipelines s’exécutent sur la même référence. Définissez la rétention, vérifiez les règles de nettoyage du registre et, lors d’un exercice, récupérez un ancien artefact avec les identifiants disponibles pour le job de récupération après la publication de releases plus récentes. Un digest identifie l’artefact sans garantir sa disponibilité continue. [1]
Le commit applicatif ne décrit pas tous les éléments consommés par la build : paquets, images de base, composants du pipeline et outils téléchargés peuvent en modifier le résultat. Pour chaque dépendance retenue, l’équipe doit connaître son origine et la version effectivement utilisée dans la build, qu’elle ait été choisie par un développeur, un bot de mise à jour ou un agent. [1]
Définir environnements et flux minimal test → préproduction → production
Prévoyez au minimum des environnements local, staging et production. Le staging doit reproduire suffisamment la topologie de production pour éprouver les migrations et les feature flags ; évitez les déploiements manuels en production fondés seulement sur le fait que l’application fonctionne sur la machine du développeur. [2]
Les petites équipes n’ont pas besoin d’une organisation de plateforme : elles ont besoin d’un pipeline qui empêche la livraison de builds dont on sait qu’ils sont défaillants et d’un rollback qui fonctionne sous pression. [2]
Le guide recommande de prendre l’artefact déployable produit à l’étape commit et de le déployer dans les environnements cloud en commençant par l’environnement de test, souvent appelé « Integration ». Cet environnement sert de porte de validation : on y vérifie que la suite de tests s’achève avec succès pour chaque release candidate, sur la version déployée intégrant les changements de la branche de fonctionnalité ou de release. Les changements déployés en test ciblent généralement la branche principale en stratégie trunk, ou une branche de release en stratégie gitflow. [3]
Rollback et migrations : options légères et conditions d'application
Prévoyez des scénarios de rollback dans la stratégie de release en cas de défaillance imprévue après un déploiement. Si aucun changement de données ne doit être annulé, vous pouvez créer une nouvelle release candidate à partir de la dernière version connue en production et la promouvoir dans le pipeline CD ; les changements apportés aux données peuvent compliquer le retour arrière. [3]
Concevez la livraison autour d'un artefact identifié, de changements contrôlés sur la cible et d'une action de récupération appropriée à l'état du service ; commencez par une application dont l'équipe maîtrise le parcours de livraison pour améliorer ensuite l'enregistrement des déploiements, la séquence et la récupération sans changer d'outil de déploiement. [1]
Définissez avec le propriétaire du service ce que la récupération doit permettre d’atteindre : un service de reporting en lecture seule pourrait tolérer une heure de disponibilité réduite, tandis qu’un service de traitement des commandes pourrait devoir préserver chaque commande acceptée pendant le rétablissement. Ces différences influencent la taille des déploiements, le temps d’observation, la protection des données et les personnes à mobiliser. Choisissez un objectif de récupération que l’équipe peut répéter, en incluant le temps nécessaire pour constater le problème et prendre une décision. [1]
Séquencement, verrous et historique de déploiement pour éviter les collisions
Dans GitLab, attribuez un même resource_group aux jobs qui modifient la même cible de production afin qu’ils s’exécutent un à la fois, tandis que les builds et les tests peuvent continuer en parallèle. Les groupes de ressources étant limités à un projet, un nom identique dans plusieurs projets ne crée pas de verrou commun. Si plusieurs dépôts modifient un même service ou une même base de données, coordonnez-les au moyen d’un projet de déploiement commun ou d’un verrou détenu par le système de déploiement. [1]
Gardez le verrou pour toute la séquence critique : un job qui lance un rollout asynchrone et libère immédiatement le verrou laisse la cible en mutation hors du contrôle ; regroupez migration et déploiement sous un job coordonnant qui conserve le lock jusqu'à la fin de la séquence. [1]
Dans GitLab, donnez des noms stables aux environnements durables, définissez le niveau de déploiement « production » pour les cibles de production et déclarez l’environnement dans le job qui réalise le déploiement. L’historique permet alors de remonter au job et au commit ; pour un job distinct qui vérifie seulement un environnement, utilisez l’action « verify » afin de ne pas créer un autre déploiement. [1]
Vérifications, observabilité et checklist post-déploiement
Le guide OnesDev recommande d’associer au pipeline un suivi des erreurs, des signaux élémentaires de latence et de disponibilité, ainsi qu’une courte checklist post-déploiement ; un pipeline réussi reste incomplet si la production manque de visibilité. [2]
Lors du smoke test de déploiement, vérifiez aussi que l’application utilise la bonne configuration, notamment qu’une production ne pointe pas par erreur vers une base UAT. Effectuez séparément les scénarios de tests d’acceptation manuels ou automatisés, puis approuvez la porte de release pour promouvoir la version vers l’environnement cloud cible, avec l’état de configuration de cet environnement. [3]
Reliez chaque déploiement au digest de l’artefact ou au checksum du paquet, ainsi qu’à la configuration utilisée, au moyen d’un manifeste de release ou d’une sortie de job liée. Lors d’un diagnostic, comparez cet enregistrement à la version indiquée par le service en cours d’exécution. Faites attendre au job de déploiement le résultat du rollout sur la cible, plutôt que de le déclarer réussi dès qu’un outil distant accepte la demande. [1]
Pour conclure
Ce pipeline léger privilégie la promotion du même artefact, les environnements local, staging et production, la coordination des changements sur une même cible et les vérifications post-déploiement. Un retour à une version antérieure dépend notamment de la disponibilité de son artefact ; les changements de données peuvent compliquer le rollback.
Pour discuter d’un pipeline adapté à votre stack et des modalités de retour arrière avec votre équipe, découvrez notre service Logiciels sur mesure.